精华速览
达瓦科技从2014年运营的科技影视片场出发,于2023年成立AI公司,选择“重控制、轻渲染”的技术路线,自研控制层基座模型Latent Stage,并推出面向专业团队的FilmOS和可在单张消费级显卡实时运行的Scenes AI。公司累计融资约5亿元,年ARR约1亿美元,通过片场积累的180TB结构化过程数据训练模型,声称能将抽卡次数从十几次降至三四次,总体成本下降50%—60%。其控制层被定位为通向Physical AI的通用能力,而非垂直模型,未来计划拓展直播、游戏等场景。
要点透视
- 达瓦科技总部位于重庆永川,团队自2014年运营科技影视片场,2023年成立AI公司,今年连续完成Pre-A轮和A轮融资,累计约5亿元人民币。
- 公司年ARR约1亿美元,收入主要来自内容制作,客户通过批量采买Token、调用API使用服务。
- 自研控制层基座模型Latent Stage采用MoE架构,总参数34B,单次激活4B,训练数据包含约180TB结构化“过程数据”,记录从剧本、机位、灯光到动作捕捉的完整拍摄过程。
- 两款产品:FilmOS面向专业内容团队做离线生成,基于一句话目标生成高质量画面;Scenes AI是实时世界模型,可在单张消费级显卡上运行,目前支持720P、每秒30帧。
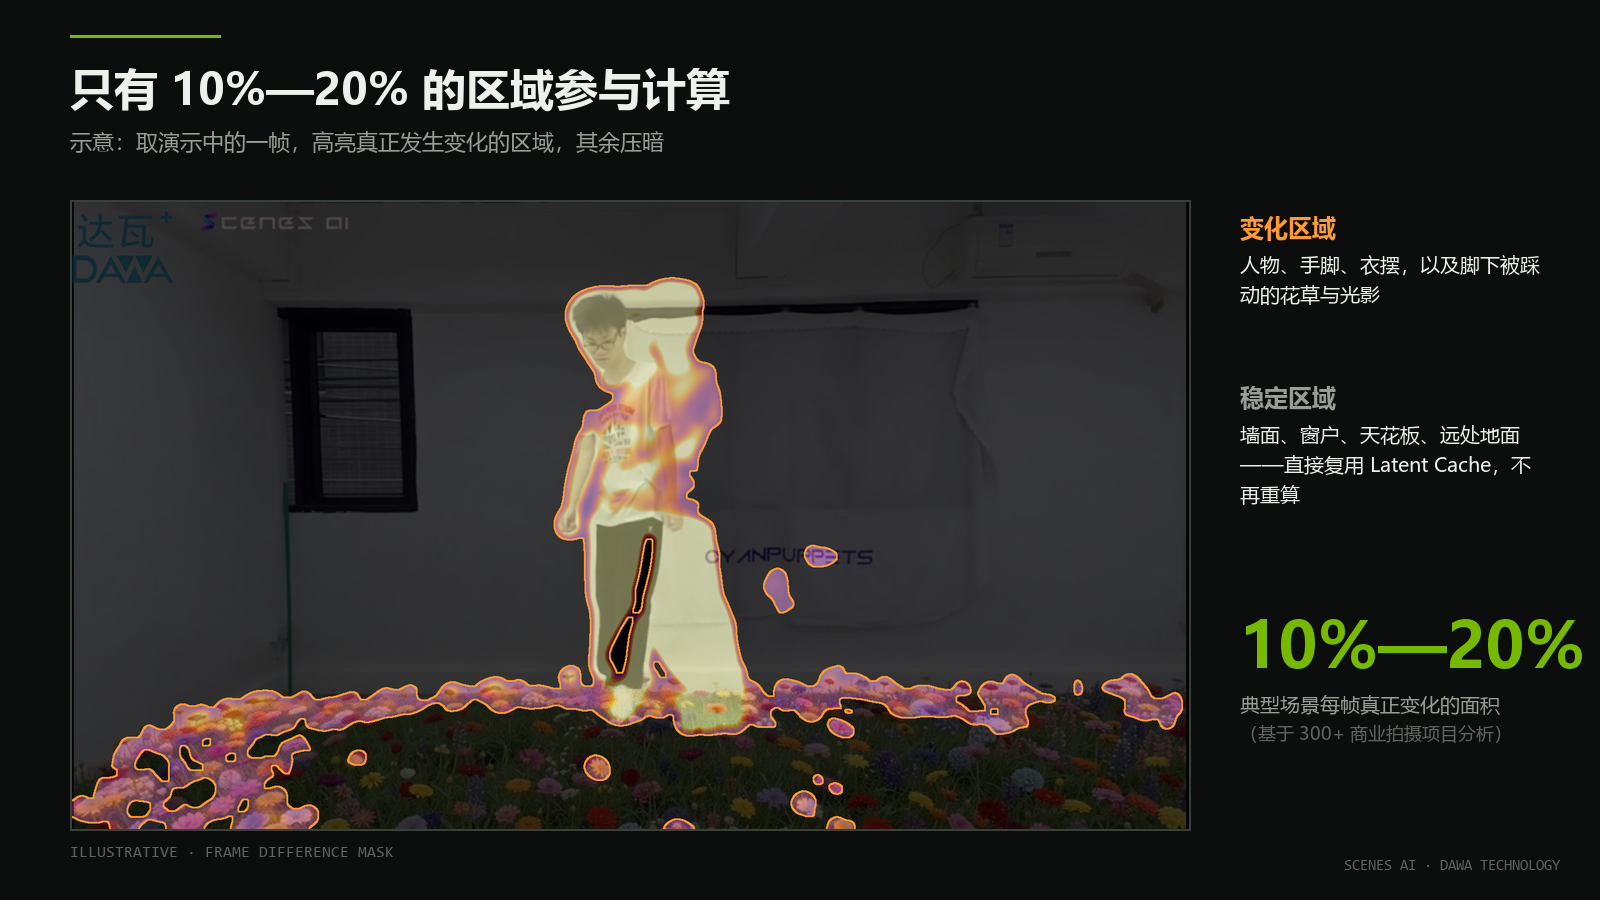
- 通过“稀疏扩散自回归”架构复用稳定区域的前空间状态,将GPU消耗降低约60%,推理速度提升3至5倍。
- 控制层使抽卡次数从原来的十次、二十次降至三到四次,总体成本下降50%—60%。
- 公司已采购英伟达Omniverse和Cosmos企业授权,用于批量生成带物理约束的仿真数据。
- 业务规划:2027年推进直播场景,年中与合作伙伴推出游戏化产品;未来希望将实时世界模型部署到客户设备,收取定期license费用。
文章拆解
达瓦科技的路径选择与主流视频生成模型形成鲜明对比。当前多数视频大模型依赖堆参数、扩算力,试图通过通用能力跨过工业门槛,但生成一条满意视频往往需要反复“抽卡”,算力和时间成本高企。达瓦则从真实片场需求出发,将视频生成拆分为控制层和渲染层:控制层像导演,理解人物、动作、镜头、灯光、场景的物理关系;渲染层像相机,负责出画面。这种分层思路的核心逻辑是,在渲染之前解决可控性和一致性问题,从而减少无效生成。
支撑这一路线的是达瓦在片场积累的约180TB结构化过程数据,涵盖剧本、机位、灯光、动作捕捉等全流程信息,并通过仿真和变体扩展数据规模。公司称其模型并非基于LLM改造,而是按片场要素拆解为多个专家模型,整体采用MoE架构。这种数据壁垒需要大量硬件、时间和项目投入,真实实拍项目减少的时间差构成一定护城河。
从用户影响看,控制层直接回应了影视行业“局部修改需重新生成整个画面”的痛点,将成本衡量从单次生成转向系统交付成本。FilmOS面向专业团队卖“结果”,Scenes AI则试图以消费级显卡实现实时世界模型,降低落地门槛。直播电商、游戏实时对战、AR眼镜等场景被列为潜在拓展方向,但多数尚处早期。
值得关注的变量包括:主流大厂若加强控制层能力,达瓦的数据优势能否持续;实时世界模型在消费级硬件上的实际表现与稳定性;从项目制收入转向license收费的商业模式能否跑通。潜在风险在于,控制层模型的效果高度依赖数据质量和物理约束的完备性,跨场景泛化仍需验证;公司计划2027年推进直播和游戏化产品,时间表较为激进,实际落地进度尚待确认。

暂无评论。