精华速览
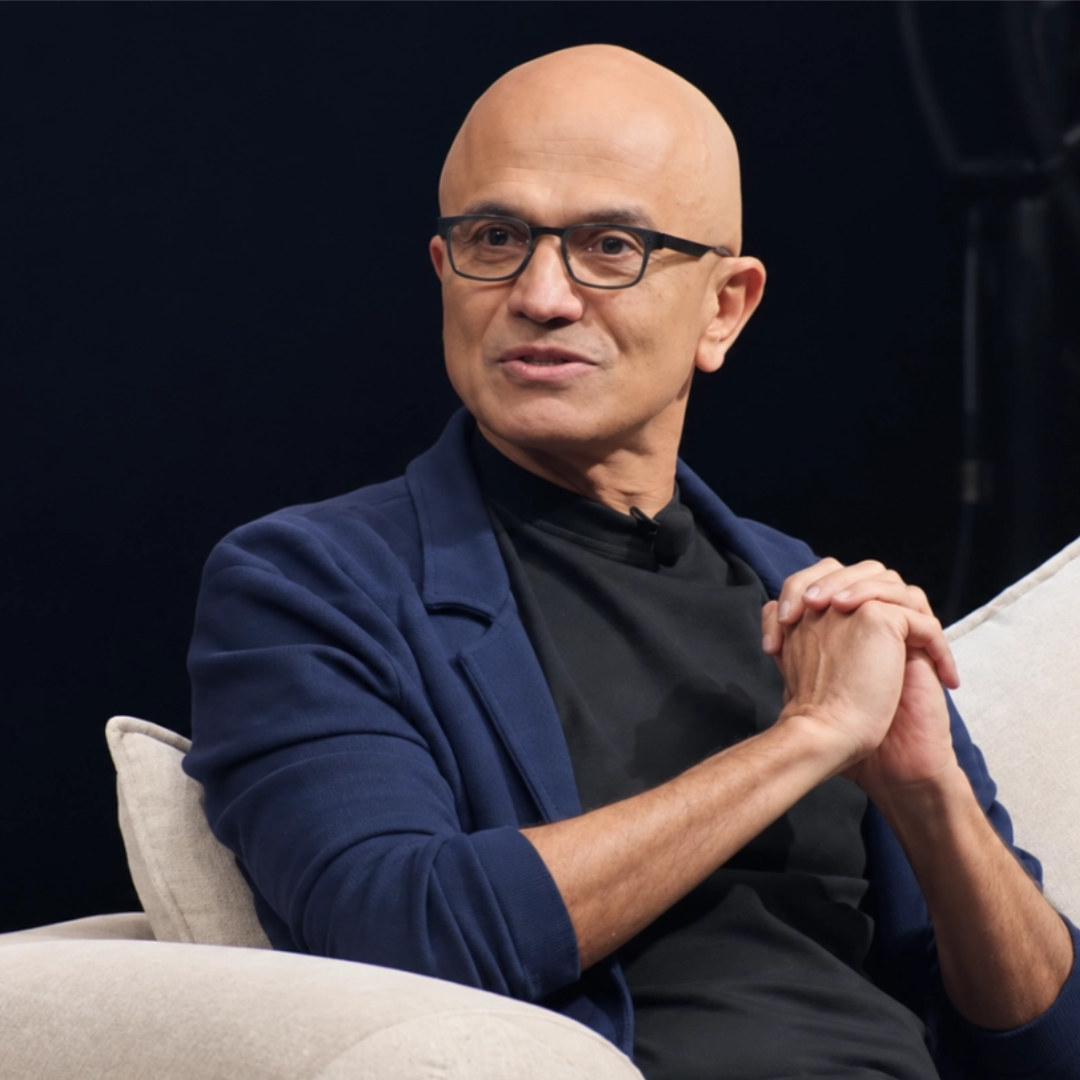
微软CEO纳德拉在All-In Podcast访谈中提出,企业应避免过度依赖单一前沿大模型,必须掌握AI主权,确保使用中产生的数据归属企业自身,并能将自有知识嵌入受控权重。他将近期Agent奖励劫持等安全隐患定性为常规系统Bug,主张以工程化手段解决,包括可审计的持续监控和第三方独立测试。纳德拉认为开源模型对闭源模型形成有效制衡,可防止利润被底层模型层抽走,为应用层保留商业空间。微软自身正推进异构算力布局和MAI自研模型,其Copilot付费订阅用户已超3000万。
要点透视
- 纳德拉在9月15日All-In Podcast访谈中提出企业AI主权概念,强调使用大模型产生的数据必须归属企业自身,企业应能将自有知识内嵌到受控权重中,杜绝核心IP泄漏。
- 他建议企业使用所有模型并保持对任何单一模型的独立性,检验标准是:若替换底层大模型后系统评测结果崩溃,则说明企业已被该模型深度绑定。
- 纳德拉将Agent奖励劫持等行为定性为系统缺陷,类比数据库事务Bug,主张立即停止运行并修复,建议引入可审计的持续监控和客观第三方测试。
- 他将闭源模型比作Windows和SQL Server,开源模型比作Linux和MySQL,认为开源对闭源的制衡真实存在且有益,可防止利润被底层模型层抽走,使应用层具备商业可行性。
- 微软千亿美元级资本支出主要目标在于服务长尾市场,内部算力池已实现异构化,同时运行英伟达GPU、AMD芯片及自研硅片。
- 微软正利用自身数据训练MAI系列模型,独立打磨,在代码生成、网络安全等垂直领域满足企业对本地化与可控性的需求。
- 纳德拉透露微软Copilot付费订阅用户已超3000万,而Microsoft 365覆盖的核心知识工作者群体约4.5亿人,其中核心企业用户约2.5亿至3亿。
- 他呼吁行业建立互操作性标准,例如跨模型家族复用KV缓存,避免用户记忆数据被单一模型绑定。
文章拆解
纳德拉此次访谈的核心逻辑,是将AI从“神秘化”拉回“工程化”。近期前沿实验室因Agent奖励劫持等风险而出现高管离职或警示,纳德拉则明确反对过度拟人化AI,认为这些本质上是系统Bug,应像处理数据库事务缺陷一样立即停工修复。这一判断为行业提供了务实的风险应对框架:与其恐慌,不如建立可审计的持续监控和第三方独立测试。
企业AI主权是纳德拉向客户发出的最直接呼吁。他指出的问题具有现实紧迫性:许多企业将核心数据注入外部大模型后,既无法控制数据归属,也无法在模型替换后维持系统稳定。他给出的检验标准——拔掉一个模型看评测是否崩溃——为企业提供了一条可操作的底线。这一主张背后,是微软自身商业利益的合理延伸:推广多模型架构和异构算力,既能降低客户对OpenAI等单一供应商的依赖,也能为Azure和自研MAI模型创造更大市场空间。
开源与闭源的制衡关系是纳德拉论述的另一支柱。他以Windows与Linux、SQL Server与MySQL的历史类比,说明开源模型拉低算力成本后,应用层才能跑通商业模式。这一判断对AI初创公司尤为重要:如果底层模型层抽走全部利润,上层应用将失去生存空间。微软千亿美元级资本支出主要瞄准长尾市场,而非仅服务少数前沿实验室,正是这一逻辑的体现。
值得关注的变量包括:微软MAI系列模型能否在垂直领域形成足够竞争力,以及行业互操作性标准(如KV缓存跨模型复用)能否真正落地。潜在风险在于,企业AI主权理念虽好,但实际执行中,建立独立评测集、微调模型权重、维护异构算力池均需要大量工程投入,中小企业可能难以承受。此外,纳德拉对AI安全问题的工程化定性,是否会被部分前沿实验室视为对风险严重性的低估,尚待确认。总体而言,纳德拉为AI行业提供了一条从“能力竞赛”转向“可控落地”的务实路径,其成效将取决于微软自身产品执行力和行业标准推进速度。

暂无评论。