精华速览
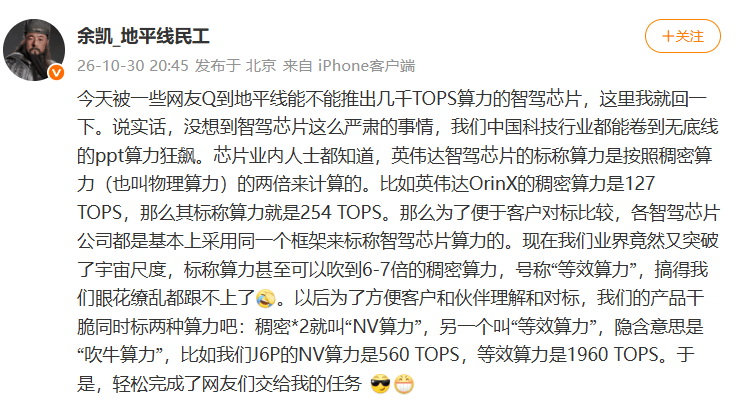
10月29日,XHEART在苏州发布智驾芯片X7 Ultra,标称700 TOPS大模型算力,实测NPU利用率达98.7%、内存带宽消耗下降80%、推理能效提升100%,测试模型为Momenta R7世界模型。次日地平线创始人余凯公开批评行业“等效算力”注水,以征程6P为例称同一芯片按等效口径可从560 TOPS写成1960 TOPS。双方虽在算力口径上分歧明显,但均认同唯TOPS论不可取。事件折射出大模型上车后,算法与硬件正从被动适配转向协同定义,芯片竞争焦点从峰值算力转向真实模型下的能效与利用率,但专用芯片的适配成本与模型迭代时间差仍是待解难题。
要点透视
- 10月29日,XHEART发布智驾芯片X7 Ultra,CEO李宗霖称其具备700 TOPS大模型算力,下一代X9目标冲击3000 TOPS。
- X7 Ultra在量产智驾模型实测中实现98.7% NPU计算利用率、内存带宽消耗下降80%、推理能效提升100%,测试模型为Momenta R7世界模型。
- 地平线创始人余凯以征程6P为例指出,该芯片NV口径算力为560 TOPS,若按行业“等效算力”算法可标称1960 TOPS,批评口径注水。
- 小鹏披露实测数据:开源模型配通用芯片计算利用率22.8%、推理耗时800毫秒;换用图灵芯片后升至35.1%、300毫秒;再配自研第二代VLA模型后达82.5%、80毫秒。
- XHEART脱胎于Momenta芯片项目,二者同源分拆、无直接股权关系,Momenta CEO曹旭东通过控股股东间接持股,XHEART董事长李俊为前Momenta芯片负责人。
- Momenta智驾搭载规模约140万辆,累计行驶超200亿公里,为XHEART提供长尾场景数据以降低芯片架构试错成本。
- X7系列量产八个月累计出货超20万颗,已搭载10款量产车型,获超40款车型订单;雷诺、奇瑞、长鑫等产业投资者入场。
- Momenta在2026年半年报业绩会议上提到,价格战正在冲击单车软件许可售价,但公司不会无底线降价。
文章拆解
大模型上车正在改变智驾芯片的评价体系。过去行业习惯以峰值TOPS作为核心卖点,但通用芯片在实际模型运行中的利用率往往远低于标称值。何小鹏曾指出通用GPU算力利用率仅30%至40%,小鹏披露的实测数据进一步量化了这一差距:同一开源模型在通用芯片上利用率22.8%,换用自研芯片后升至35.1%,再叠加自研模型后达到82.5%。这说明算力数字本身并不等于可用性能,模型与硬件的匹配度才是关键变量。余凯与李宗霖的分歧表面在口径,实质是两种竞争策略:一方要求统一折算方法以遏制虚标,另一方主张以量产模型实测说话,但双方都承认唯TOPS论已经失效。
XHEART的路径是把模型需求前移到芯片定义阶段。Momenta从芯片架构阶段介入,将传统NPU小核切分改为超大核,并为高频低体量任务配置专用加速引擎,配套编译工具可统筹整张网络的执行顺序与数据驻留。其底气来自Momenta约140万辆搭载规模和超200亿公里行驶数据,使芯片能提前了解长尾场景所需的冗余。这一模式降低了试错成本,但也带来适配性收窄的问题:专用芯片以更窄的模型适配换取更高效率,开放性和兼容性相应下降。
更深层的矛盾在于芯片与模型的时间差。芯片从架构到量产需数年,模型可能数月迭代一次,X7 Ultra留给缓存的面积在架构确定后难以调整。它能否经受至少一次模型换代检验,将直接影响XHEART下一轮融资窗口。与此同时,英伟达Orin的生态优势仍难撼动:CUDA、TensorRT和DRIVE OS构成的工具链让工程师可在原芯片上交付新功能,车企明知算力存在浪费仍愿采购,看中的是算法落地的确定性和OTA预埋空间。专用芯片若不能把单一模型的深度优化转化为多模型可迁移能力,开放编译器、算子库和SDK并公开同条件延迟与功耗数据,省下的算力很可能被工程适配成本吞掉。
对Momenta而言,押注XHEART是技术路线收束后的重注,但跨平台生意并未放弃,其与英伟达Orin、Thor及高通骁龙Ride多平台合作仍在,算法正从完全开放转向分层开放。地平线则从芯片侧向算法和整套方案延伸,征程6P配套HSD软件及HSD Together授权模式。两家都在软硬一体中寻找开放与控制的平衡点。XHEART能否从Momenta的芯片部门成长为独立芯片企业,取决于X7 Ultra能否跨模型复用并证明架构的持续竞争力,这一验证过程尚待市场给出答案。
暂无评论。