精华速览
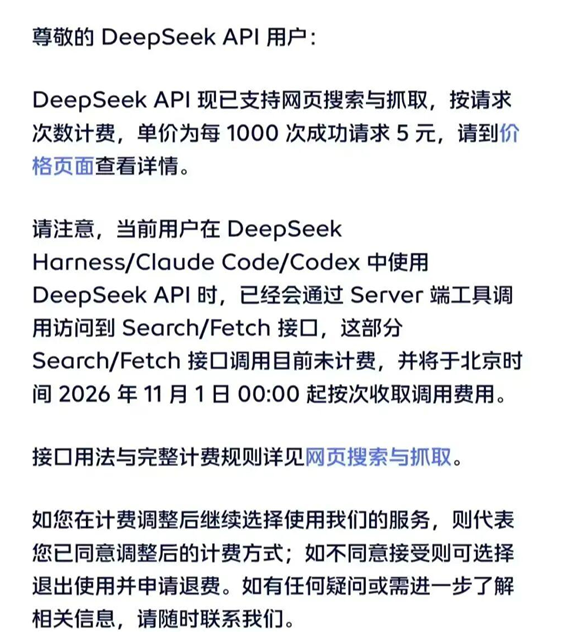
DeepSeek上线Search与Fetch两个新接口,底层由自研搜索引擎驱动,分别负责按query返回结构化网页结果、抓取单页并以Markdown格式返回标题与正文,与主API共用Bearer鉴权,各限速每秒5次。定价为每1000次成功请求5元(约0.75美元),失败、无结果或超时不计费,11月1日零点起正式收费。此前在DeepSeek Harness、Claude Code、Codex中,模型已通过服务端工具调用使用这两个接口,一直免费。横向对比,该价格约为Tavily的十分之一,也低于Brave、Google Custom Search及Serper等海外方案,是主流大模型厂商中少见的自研搜索引擎对外开放动作。
要点透视
- DeepSeek新增Search和Fetch两个接口:Search按query搜索网页并返回结构化结果,Fetch抓取单个网页并以Markdown格式返回标题和正文,二者共用主API的Bearer鉴权,各限速每秒5次。
- 计费规则为每1000次成功请求5元(国际定价约0.75美元),请求失败、搜索无结果或超时均不计费,11月1日零点起正式收费。
- 收费前,DeepSeek Harness、Claude Code、Codex中的模型已通过服务端工具调用访问这两个接口,联网能力此前免费内嵌在编程智能体工作流中。
- 价格对比:Tavily按量付费约8美元/千次,Brave Search与Google Custom Search约5美元/千次,Exa基础档4美元/千次、深度档最高15美元,Serper约1美元/千次。
- DeepSeek未公布搜索质量指标,索引规模、内容新鲜度和反爬能力与Google、Bing等成熟搜索引擎的积累不在同一量级。
- 每秒5次的限速对高并发Agent集群构成硬约束,企业级负载可能面临排队;搜索与抓取绑定自家API,也使开发者数据管道进一步向单一厂商集中。
文章拆解
这则定价公告的意义不止于价格。DeepSeek把搜索和抓取做成独立API,而不是打包进模型,符合Agent时代的常见做法:模型权重静态、知识存在截断日期,而编程智能体查文档、看报错、追issue都需要实时信息。过去开发者要自己接Google或Bing的搜索API,再处理爬取、清洗和格式转换;DeepSeek把这条链路收进自家体系,模型判断需要联网时自动调用Search和Fetch,干净的Markdown直接进入上下文,开发者无需写爬虫代码,代价是按次付费。
按成功计费是这套机制的关键设计。失败、无结果和超时不计费,相当于平台承担了搜索质量的试错成本,模型可以多搜几次,用户只为拿到结果的那次买单;每秒5次的限速则把服务对象限定为Agent调用,而非爬虫农场。
价格是更直接的竞争手段。0.75美元/千次约为Tavily的十分之一,也低于Brave、Google Custom Search和Serper,属于激进定价。对DeepSeek而言,Agent调用搜索是刚性需求,编程场景中查API文档、看GitHub issue每天都在Claude Code和Codex里成规模发生;免费期培养使用习惯,等到11月1日收费时切换成本已经较高。搜索数据还能反哺DeepSeek对用户真实查询意图的理解,这是模型迭代中稀缺的信号。
风险同样明显。自研搜索引擎的索引规模、freshness和反爬能力与Google、Bing数十年的积累不在一个量级,DeepSeek没有公布任何搜索质量指标,目前只能判断其“能用”,是否“好用”尚待确认。限速对高并发Agent集群是硬约束,企业级负载大概率要排队。把搜索和抓取绑定在自家API里,也意味着开发者的数据管道进一步向单一厂商集中,在多云策略盛行的当下未必被所有团队接受。
更大的图景是DeepSeek沿Agent技术栈向下延伸:从模型到Harness框架,再到搜索引擎。搜索是互联网入口级基础设施,敢碰它的模型公司不多——Google自身就是搜索引擎,OpenAI依赖Bing,Anthropic至今没有公开的自研搜索。DeepSeek选择最重的一条路,好处是数据与体验闭环,代价是要同时应对模型和搜索两场竞争。千次5元在AI基础设施语境里接近免费,但“免费试用、到期收费”是平台级生意的常见起手式;联网能力从Agent的选配变为标配,转折点可能就藏在这则公告里,接下来要看搜索质量能否撑住这一野心。

暂无评论。