精华速览
DeepMind 机器学习专家 Nicholas Carlini 在 2024 年 8 月 17 日发表长文,基于过去一年与多个大语言模型的真实交互,详细展示了 50 个提升工作效率的用例。他明确表示,这些模型让他的编程效率至少提高了 50%,并几乎取代了网络搜索用于调试和查询 API。Carlini 将用例归纳为“助力学习”和“简化乏味工作”两类,强调当前模型已具备实质生产力价值,既非炒作,也远未达到取代程序员的地步。他同时指出,模型存在幻觉、伦理等局限,但不应因此否定其现实效用。
要点透视
- Nicholas Carlini 是 DeepMind 的机器学习专家,过去一年每周都会花时间与不同大语言模型互动。
- 他估计大语言模型让他在编写研究项目和个人项目代码时,效率至少提高了 50%。
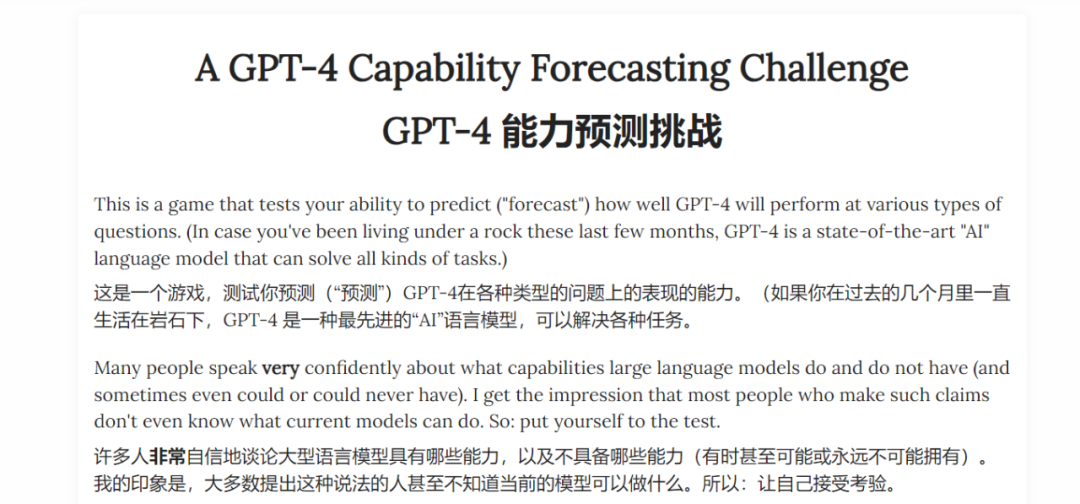
- 他使用 GPT-4 几乎从零构建了一个预测 GPT-4 任务解决能力的测试网站,该网站浏览量已超过一千万。
- 他通过大语言模型学习 Docker、Podman、CUDA、React、Flexbox 等此前不熟悉的技术,并完成实际项目配置。
- 他将 500 行 C++ 代码输入 LLM,成功获得更简洁版本,并生成 Python 封装器,使工具速度比原 Python 代码快 100 倍。
- 他利用 LLM 完成 Python 3.9 程序反编译、非结构化数据整理、代码差异转 HTML、自动生成引用等重复性任务。
- 他在 Emacs 编辑器和 shell 中内置了 LLM 查询工具,约 90% 的 API 参考类查询无需离开编辑环境。
- 他强调展示的案例不到 LLM 帮助他的全部案例的 2%,且所有对话链接均公开可查。
文章拆解
Carlini 的分享之所以值得关注,是因为它来自一位长期研究 AI 模型安全漏洞的专家。他过去近十年的工作就是证明机器学习模型在对抗性环境下如何失败,因此他对模型局限性的认知比多数人更深。即便如此,他仍认为当前大语言模型是自互联网诞生以来对生产力提升最大的技术。这一判断建立在大量真实、可验证的日常使用之上,而非实验室基准或未来预测。
从核心逻辑看,Carlini 将 LLM 的价值锚定在“降低启动成本”和“消除重复劳动”两个维度。对于不熟悉的框架或工具,传统学习路径需要购买书籍、搜索教程、调试错误,而 LLM 提供实时、交互式的引导,让用户只需掌握完成任务所需的最小知识。对于反编译、数据格式化、引用生成等枯燥任务,LLM 则直接替代了人工操作,使开发者能将精力集中在真正需要创造力的部分。这种“基础水平提升”对非专业人士的效用可能比专业人士更大,因为后者原本就具备高效完成这些任务的能力。
对行业和用户而言,Carlini 的案例暗示了一个现实:LLM 的采用不一定要等待模型完美。即便存在幻觉和错误,只要用户保持核实习惯,模型仍能显著压缩任务时间。他本人会亲自核实自动生成的引用,也会在 LLM 生成的 CUDA 代码基础上自行修正。这种“人机协作”模式可能成为短期内最务实的工作流。
值得关注的变量包括:模型能力持续提升是否会改变“50% 效率提升”的估算;企业是否会将此类个人实践转化为团队规范;以及 LLM 对网络搜索、技术教程生态的替代效应。潜在风险则在于,过度依赖模型可能削弱开发者对底层原理的理解,而模型训练数据的伦理争议和版权问题仍未解决。Carlini 明确表示,这些负面议题需要单独讨论,不应与“当前模型是否有用”混为一谈。至于他提到的“未来模型可能带来的有害影响”,他计划另文阐述,具体内容尚待确认。
暂无评论。