精华速览
在上海举办的 Arm Everywhere China 活动上,Arm 首次系统性地将未来方向拆分为云 AI、边缘 AI 和物理 AI 三条线,并发布 CSS for Mobile 2、Neoverse CSS N4、C2 CPU、Mali G2-Ultra NX GPU 等一系列产品。与去年聚焦 SME2 架构升级不同,Arm 今年强调算力将在云、端侧和物理世界之间流动,自身定位从 CPU IP 供应商转向 AI 计算基础设施平台。Arm 明确表示不预设未来计算范式,将调度权交给系统所有者,通过 CSS、软件生态和系统级优化,让不同计算资源更高效协同。
要点透视
- Arm 基于其技术的芯片累计出货量已超过 3500 亿颗,过去以 CPU 架构和 IP 授权连接半导体产业。
- Arm 引用 IDC 数据称,基于 Arm 架构的机架级服务器市场规模已超越 x86,成为加速计算的主流平台。
- CSS for Mobile 2 被定义为首个 AI 原生移动计算子系统,包含 C2 CPU 集群、Mali G2-Ultra NX GPU、SI L2 系统互连及软件工具,AI 模型性能最高提升 1.7 倍。
- Neoverse CSS N4 是 Arm 迄今可配置性最高的 CSS,单颗裸片支持 128 个 CPU 核心,首款支持 LPDDR6 和 PCIe Gen 7,相比 N3 插槽性能最高提升至 2 倍,每瓦性能最高提升 25%。
- C2-Ultra CPU 单线程性能提升 15%,多线程性能提升 12%,相同性能下功耗最高降低 38%,Arm 强调其在 AI Agent 任务链路中承担基础组织角色。
- Mali G2-Ultra NX 是首款将神经网络加速器直接集成到着色器内核的 Mali GPU,支持 int8 和 int16 计算,神经加速器运行频率最高可达 GPU 时钟频率两倍,功耗不到 1 瓦。
- Arm 将神经图形相关模型开源至 Hugging Face 和 GitHub,展示项目《光影新生》计划在 6 至 12 个月内上线。
- 联想高级副总裁贾朝晖在活动现场判断,未来可能有 80% 的 Token 生成发生在本地设备上。
文章拆解
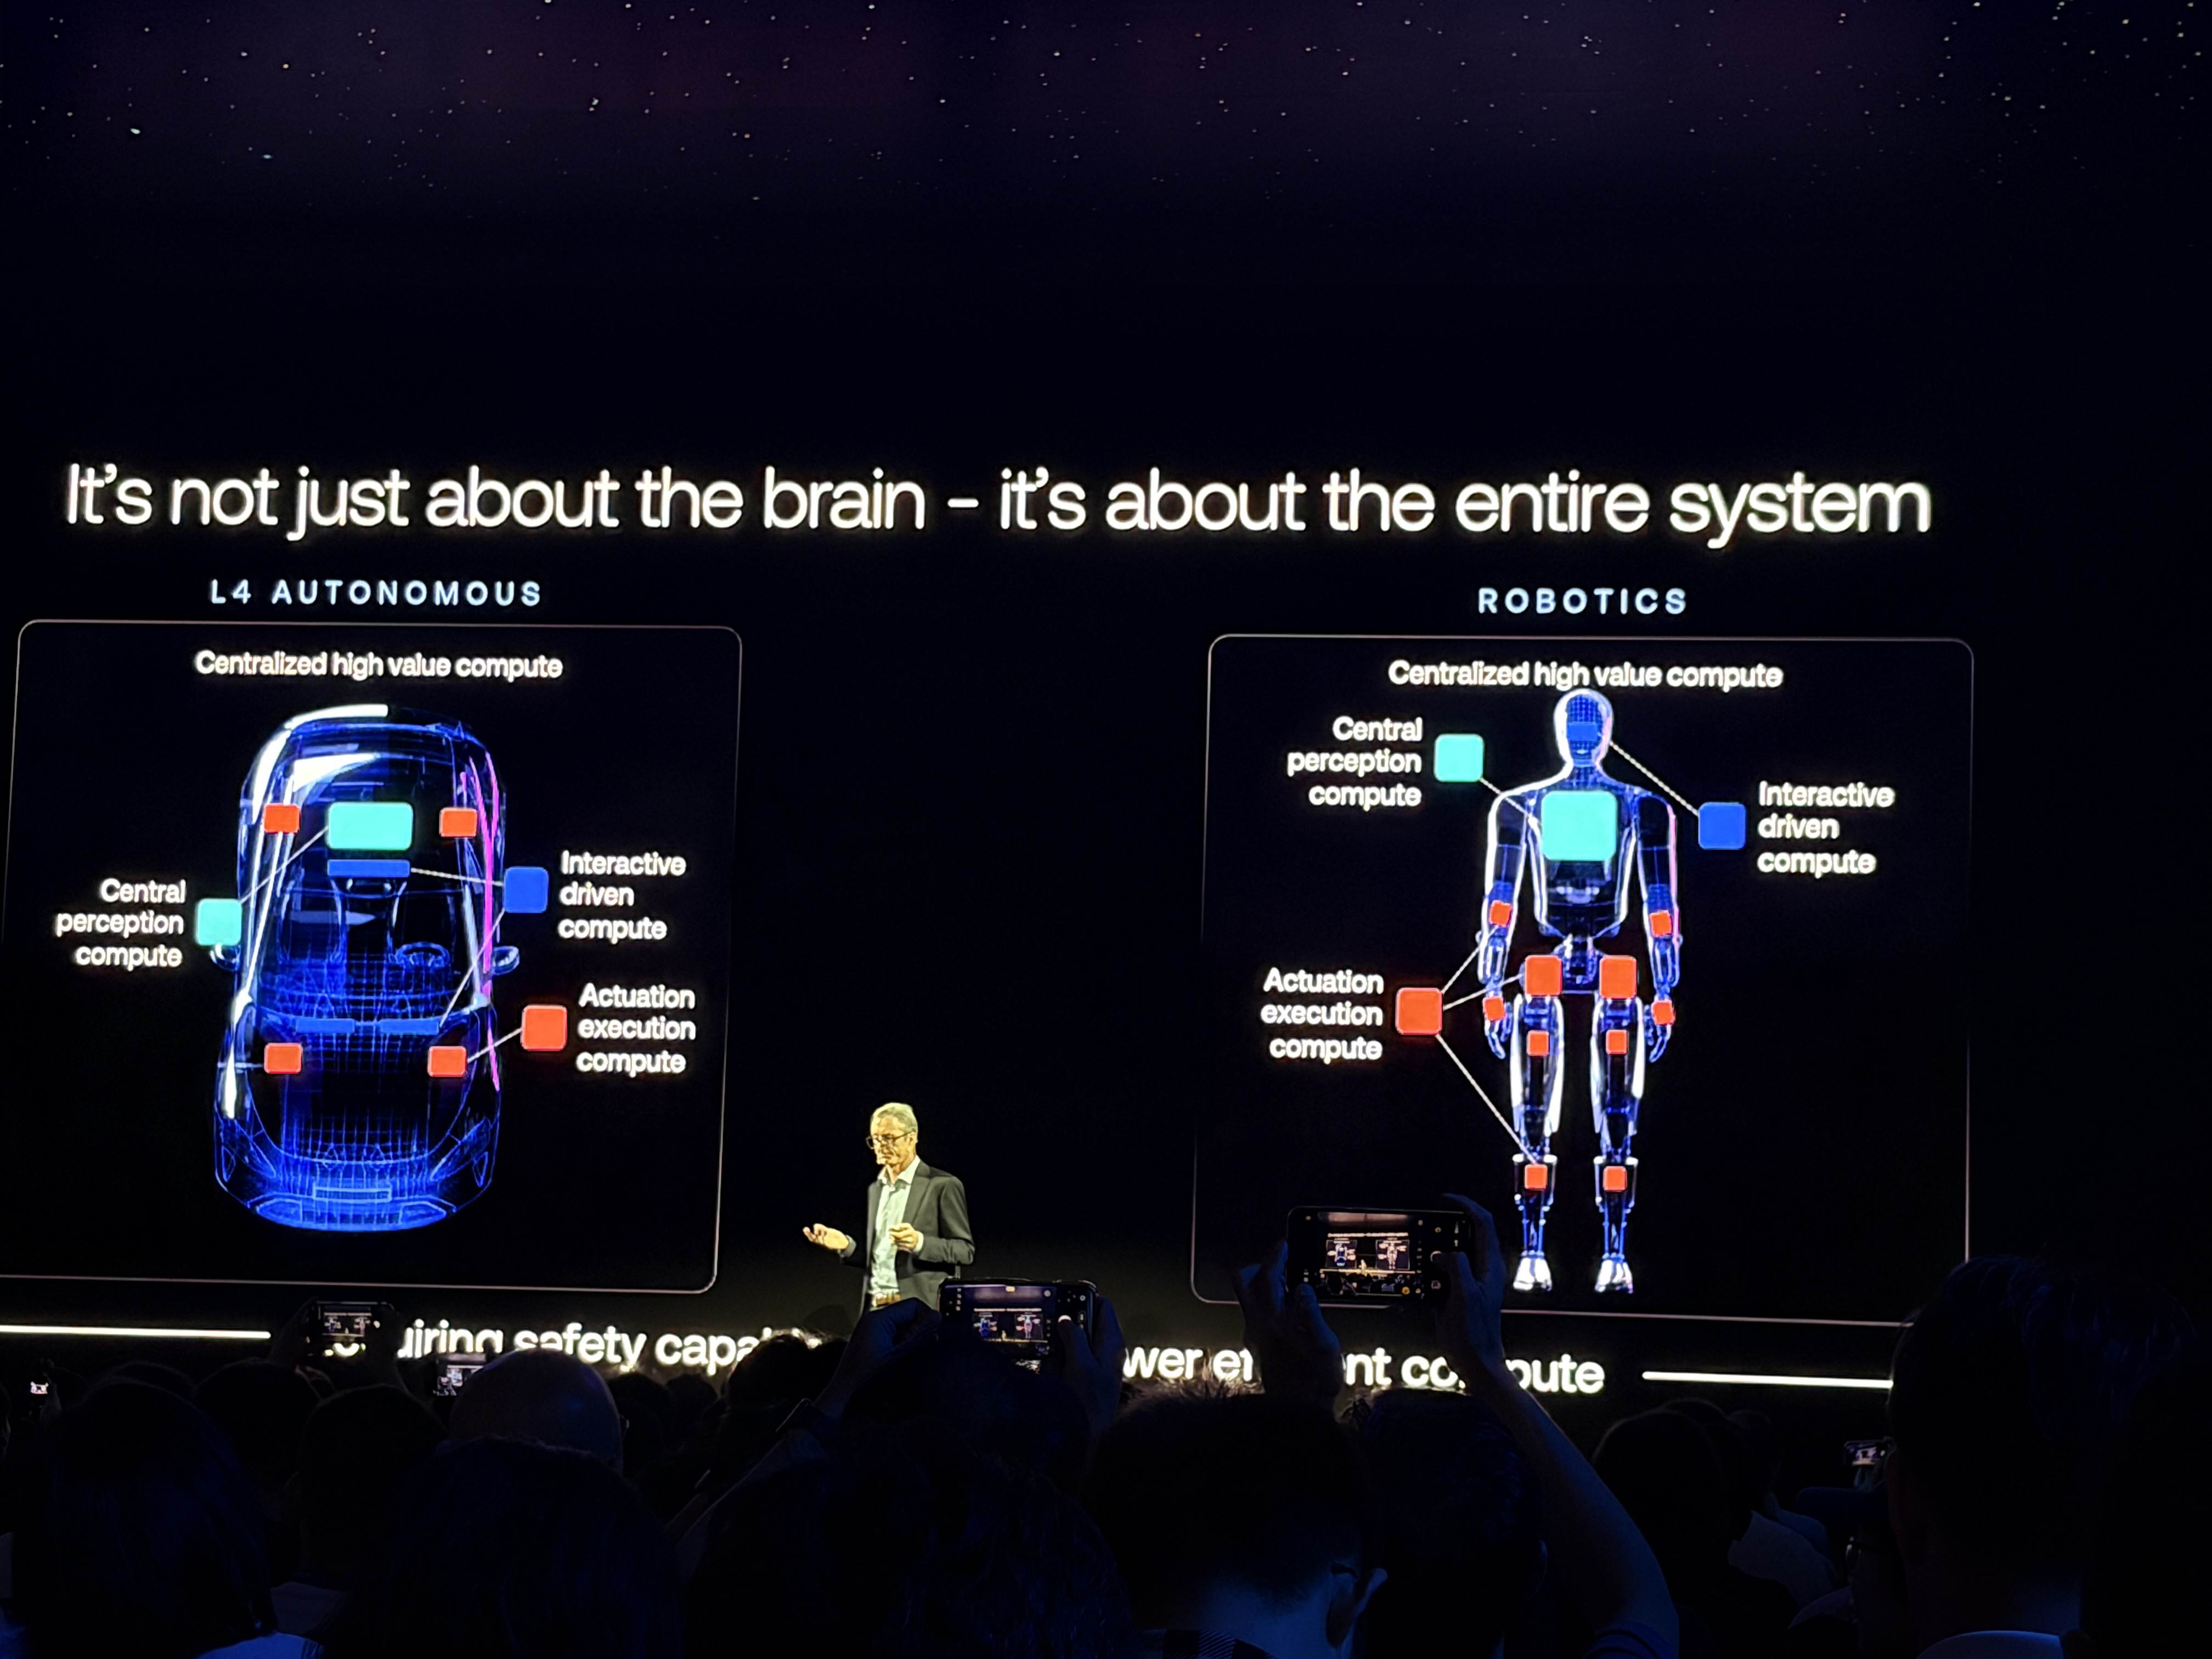
Arm 此次活动的核心变化,在于它不再以单一产品发布来定义自己。去年主题演讲几乎全部围绕 SME2 展开,本质是架构升级叙事;今年三位业务负责人分别讲述边缘 AI、物理 AI 和云 AI,叙事逻辑转向场景驱动。这一转变的背景是,AI 任务正从单次计算走向连续推理、多模态交互和智能体式执行,一次完整任务可能涉及 CPU、GPU、NPU 和云端的协同,单一计算单元的峰值性能已不足以决定体验。Arm 的判断是,未来竞争的关键不只是拥有多少算力,而是如何组织这些算力。
从产品层面看,Arm 的应对策略是提供更完整的平台能力,而非替客户做决定。CSS 模式让客户可以购买 IP、CSS 甚至芯片,微软基于 Neoverse CSS 在 18 个月内完成两代 Cobalt CPU 交付,云豹智能基于 CSS N2 构建 DPU 产品,说明该模式已在产业链中得到验证。C2 CPU 和 SME2 的组合则回应了“AI 时代 CPU 是否会被 NPU 取代”的疑问,Arm 认为 CPU 不会取代 NPU,而是在智能体任务链路中承担低延迟响应、系统资源访问和跨单元协同的基础角色。Mali G2-Ultra NX 将神经加速器集成进着色器内核,意味着 AI 开始进入传统图形管线,移动端有望以更低功耗实现接近 PC 级的视觉效果。
Arm 与英伟达的路线差异值得关注。英伟达通过 CUDA 构建从硬件到软件的完整平台,用相对确定的范式锁定开发者;Arm 则选择拥抱不确定性,将 CPU、GPU、NPU 之间的任务分配权交给系统所有者,自身只保证每一种选择都能跑得更好。这一策略延续了 Arm 长期商业模式——不制造最终设备,而是通过开放架构让不同厂商基于 Arm 设计产品。但这也意味着 Arm 不直接掌握 AI 调度层,其影响力取决于 CSS、KleidiAI 等平台能力能否被 OEM、芯片设计公司和软件开发者广泛采用。
潜在变量和风险同样存在。端侧模型规模、智能体算力应放在 CPU、NPU 还是云端,目前均无明确答案,Arm 高管在沟通中也多次以“待定”“取决于市场需要”回应。联想提出的“80% Token 在本地生成”是一个激进判断,能否实现尚待确认。如果未来调度权分散在众多系统所有者手中,Arm 能否持续保持计算基础设施的核心地位,将取决于其软件生态的调用效率和跨设备迁移能力。此外,CSS 跨领域复用还是持续分化,Arm 表示取决于客户需求,这意味着其平台战略的最终形态仍处于动态调整中。

暂无评论。