精华速览
在9月17日至19日举行的华为2026年全联接大会上,华为围绕灵衢互联架构与超节点集群发布昇腾960芯片、昇腾960超节点、OceanStor M900 AI记忆存储等AI基础设施新品。灵衢是华为算力底座的统一互联总线协议,将CPU、NPU、DPU、内存、SSD等统一互联,贯穿单机、超节点和超大规模集群。华为公布数据显示,基于灵衢的单集群可支持100万颗AI处理器,10万卡集群的模型浮点算力利用率从20%提升至35%,互联带宽从百GB级提升到TB级,RTT时延从7微秒压缩至2微秒。昇腾960风冷和液冷超节点将分别于2027年Q2和Q3上市。
要点透视
- 华为在2026年全联接大会(9月17日-19日)发布灵衢互联架构及昇腾960芯片、昇腾960超节点、OceanStor M900 AI记忆存储等新品。
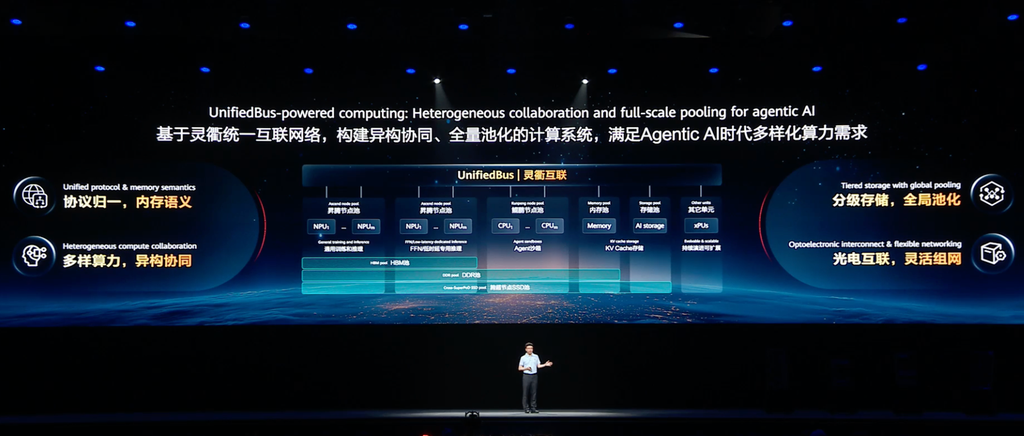
- 灵衢是统一互联总线协议,将CPU、NPU、DPU、DDR、SSD等统一互联,实现十几种协议归一,互联带宽从百GB级提升到TB级,RTT时延从7微秒压缩至2微秒,降低约70%。
- 基于灵衢,10万卡集群的模型浮点算力利用率(MFU)从20%提升至35%,单集群可支持100万颗AI处理器。
- 单个昇腾960超节点可实现4096卡规模,最大提供8 EFLOPS FP8算力,高达1PB HBM容量,系统可用度达99.8%,风冷和液冷版本分别于2027年Q2和Q3上市。
- 鲲鹏950超节点单柜提供12288个CPU核、192TB内存,基于灵衢可实现超过150万核统一调度和24000TB内存全局池化。
- OceanStor M900通过“三芯合一”实现单ASU模组64TB容量密度,单节点访问带宽达480GB/s。
- Atlas 650E通过双机灵衢直连实现16个NPU Full-Mesh组网,无需交换机,支持万亿参数模型,推理吞吐提升40%以上,时延低至10毫秒。
- CANN社区月活开发者达5200多人,50多家头部客户及伙伴打造26个行业专属算子库,华为与90多家主流开源社区合作。
文章拆解
华为此次发布的核心逻辑,是把AI Agent时代的算力瓶颈从“芯片算力”转向“通信效率”。随着模型参数从万亿级走向10万亿级、上下文从几K级走向几M级,数据并行域内通信量与参数量呈近似平方关系,传统PCIe加RoCE体系下10万卡集群MFU不足20%。华为的判断是,继续在旧协议上叠补丁收益递减,必须从协议层重构互联。灵衢通过协议归一、统一内存语义、异构协同、分级池化和光电互联,试图把通信从“瓶颈”变成“底座”。
从行业影响看,灵衢的意义在于为超大规模集群提供了一条可扩展路径:单柜172T带宽、4096卡超节点、1024 Radix扇出、两层CLOS组网,最终指向百万卡集群。这直接回应了MoE模型和长上下文推理对带宽与时延的苛刻需求。同时,华为将灵衢下沉到Atlas 650E一体机,让中小企业在本地运行万亿参数模型,意味着其算力策略并非只瞄准头部大厂,而是试图覆盖从桌面级到百万卡的全场景。
值得关注的变量有三。其一,昇腾960超节点要到2027年Q2和Q3才上市,当前发布更多是架构宣示,实际落地节奏尚待确认。其二,灵衢作为统一协议,其生态开放程度和第三方硬件适配进度,将决定它能否从华为内部体系走向产业标准。其三,华为强调CANN开源和26个行业算子库,但Agent开发生态仍处于协同框架阶段,插件化组件的成熟度尚待验证。
潜在风险在于,百万卡集群的工程复杂度、光电互联的可靠性与功耗、以及跨柜光路保护的实际表现,都需要大规模部署验证。此外,AI Agent负载的多样性意味着没有一种算力配比能通吃所有场景,灵衢的灵活配比能力能否在真实业务中兑现,仍需观察。总体而言,华为正以“计算加通信”的垂直整合能力,为10万亿级大模型时代构筑算力底座,但这场体系化能力较量的胜负,最终取决于生态落地速度与规模部署的稳定性。

暂无评论。